GPT-6 Astra: คู่มือจาก OpenAI
จากเอกสารทางการของ OpenAI Developers – Model guidance ซึ่งตอนนี้เนื้อหาหลักของหน้าได้เปลี่ยนมาเป็น GPT-6 Astra และน่าสนใจมาก เพราะไม่ได้อธิบายเพียงว่าโมเดลเก่งขึ้นตรงไหน แต่บอกตรง ๆ ว่า “พฤติกรรมของโมเดลเปลี่ยนไปอย่างไร และเราควรเขียน Prompt อย่างไรให้เหมาะกับมัน”
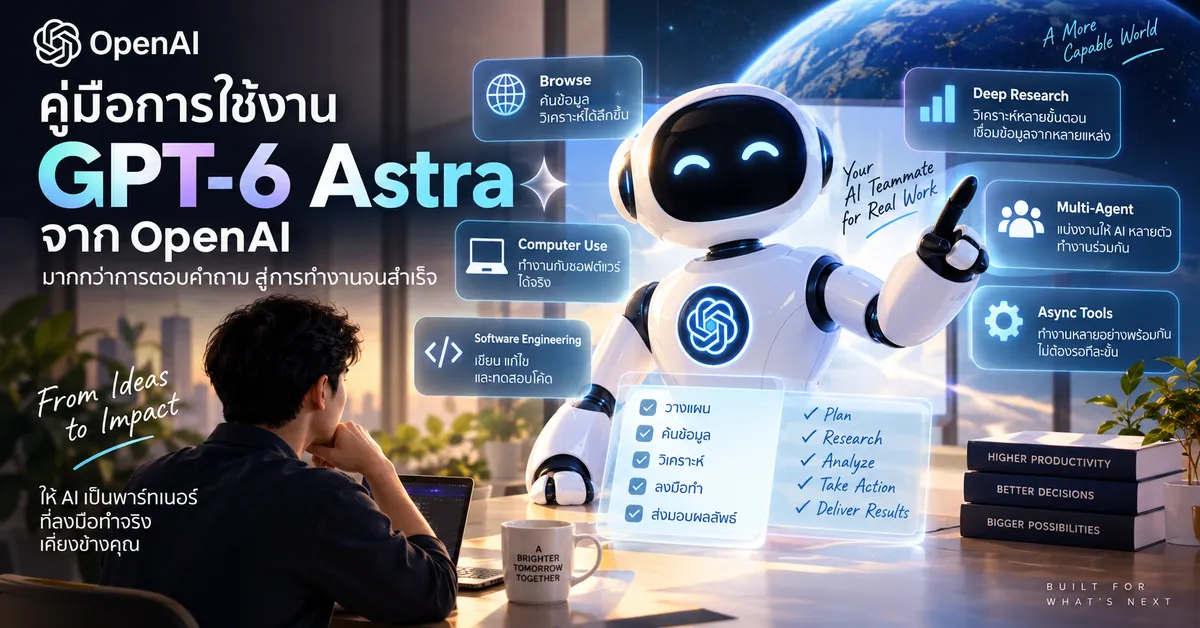
OpenAI ระบุว่า GPT-6 Astra เป็นโมเดลที่ฉลาดที่สุดของบริษัทในขณะนี้ โดยเด่นด้าน Computer Use, การท่องเว็บ, Software Engineering, Science และ Professional Work รวมถึงงานหลายขั้นตอนที่ต้องสลับไปมาระหว่างโค้ด เว็บ และซอฟต์แวร์ต่าง ๆ นอกจากนี้ OpenAI ระบุว่าในการประเมินหลายชุด Astra ให้ผลลัพธ์ดีกว่าโดยใช้ output tokens ลดลงมาก จึงอาจมีต้นทุนต่อ “งานที่ทำสำเร็จ” ต่ำกว่าโมเดลก่อนหน้า แม้ราคาต่อ token จะสูงกว่า (OpenAI Developers)
จุดเปลี่ยนสำคัญ: จาก “ตอบคำถาม” ไปสู่ “ทำงานให้เสร็จ”
ประเด็นที่ผมคิดว่าสำคัญที่สุดของเอกสารนี้คือ OpenAI กำลังสอนนักพัฒนาให้คิดกับ Astra ในลักษณะของ Agent ที่รับเป้าหมายแล้วเดินหน้าทำงาน มากกว่า chatbot ที่รอรับคำสั่งทีละขั้น
OpenAI บอกว่า Astra ทำงานระยะยาวได้ต่อเนื่องกว่า GPT-5.6 Sol และรุ่นก่อนหน้า แต่มีพฤติกรรมหนึ่งที่ต้องเข้าใจ คือมันมีแนวโน้มถามคำถามเพิ่มเติมเมื่อเห็นว่าข้อมูลจากผู้ใช้อาจเปลี่ยนผลลัพธ์ได้ ซึ่งในบาง workflow อาจกลายเป็นปัญหา เพราะผู้ใช้อาจต้องการให้ AI ใช้สมมติฐานที่สมเหตุสมผลแล้วทำงานต่อเลย (OpenAI Developers)
เพราะฉะนั้น OpenAI จึงแนะนำแนว Prompt ประมาณว่า:
ให้ตีความเจตนาและขอบเขตงานจากคำสั่ง รวมถึงบริบทก่อนหน้า แล้วโน้มเอียงไปทางการลงมือทำและทำงานให้เสร็จ
แนวคิดนี้สำคัญมากสำหรับคนที่เคยเขียน Prompt แบบ
“ช่วยวางแผนเรื่องนี้ให้หน่อย”
เพราะ Astra อาจมองว่ามีข้อมูลบางอย่างที่ยังขาดและถามกลับ แต่ถ้าเราต้องการ Agent ที่มี autonomy สูงกว่า ควรกำหนดพฤติกรรมไว้ตั้งแต่ต้นว่า เรื่องที่อนุมานอย่างสมเหตุสมผลได้ ให้ตัดสินใจแล้วเดินหน้าต่อ (OpenAI Developers)
คำว่า “ช่วยทำ...” ควรถูกตีความว่าเป็นคำสั่งให้ลงมือทำ
นี่เป็นรายละเอียดเล็ก ๆ ที่ผมว่าน่าสนใจมาก
OpenAI แนะนำว่า ถ้าผู้ใช้พูดในลักษณะ
“Can you...”
“I want to...”
“Help me...”
ระบบสามารถถูกกำหนดให้ถือว่านี่คือ authorization ให้เริ่มทำงาน ไม่ใช่แค่คำถามว่า “คุณทำได้หรือไม่”
เช่น
“ช่วยผมแก้เว็บไซต์นี้หน่อย”
พฤติกรรมที่เราไม่ต้องการคือ
“ได้ครับ ผมสามารถช่วยคุณแก้เว็บไซต์ได้ โดยมีขั้นตอนดังนี้...”
แล้วหยุด
แต่พฤติกรรมที่ต้องการคือ วิเคราะห์ปัญหา → เปิดไฟล์ → แก้ → ตรวจสอบ → ส่งผลลัพธ์
OpenAI ถึงกับแนะนำไม่ให้ Agent หยุดอยู่ที่การ acknowledgment, การเสนอแผน หรือ solution แบบ “helpful enough” ถ้างานจริงยังไม่เสร็จ (OpenAI Developers)
นี่คือแนวคิด Bias toward Action ที่ชัดมากใน Astra
อย่าถาม permission เร็วเกินไป
อีกหลักการที่น่าสนใจคือ ถ้ามีงานบางอย่างที่ต้องได้รับอนุมัติจากผู้ใช้ เช่น
แก้ระบบ → Deploy
เตรียม PR → Merge
สร้างเว็บไซต์ → Publish
ร่างข้อความ → ส่งออกไปจริง
OpenAI แนะนำให้ AI ทำส่วนที่ทำได้ทั้งหมดก่อน แล้วค่อยขออนุมัติในขั้นสุดท้าย
เช่น แทนที่จะถามตั้งแต่ต้นว่า
“ต้องการให้ผมแก้และ Deploy เลยไหม?”
Agent ควรตรวจสอบปัญหา แก้โค้ด ตรวจสอบผล และเตรียมทุกอย่างให้พร้อม จากนั้นค่อยถามเรื่อง Deploy
สำหรับงานที่ย้อนกลับได้ งานอ่านข้อมูล งาน review หรือสิ่งที่ผู้ใช้ได้อนุญาตไว้แล้ว ไม่จำเป็นต้องขอ permission ซ้ำโดยไม่มีเหตุผล (OpenAI Developers)
Astra มี Async Tool Calling
นี่เป็นความสามารถใหม่ที่สำคัญมากสำหรับการสร้าง Agent
ปกติ workflow อาจเป็น
AI
↓
เรียก Tool A
↓
รอ Tool A
↓
ได้ผลลัพธ์
↓
คิดต่อ
↓
เรียก Tool B
แต่ Astra รองรับ Async Tool Calling
จึงสามารถเกิด workflow แบบ
             ┌→ Tool A ─────────┐
             │                  │
GPT-6 Astra ─┼→ คิดงานส่วนอื่น  ├→ รวมผลลัพธ์
             │                  │
             └→ Tool B ─────────┘
โมเดลสามารถ reasoning ต่อ เรียกเครื่องมืออื่น หรือทำส่วนที่ไม่ต้องพึ่งผลของ Tool A ระหว่างที่ Tool A ยังทำงานอยู่ได้ โดยฝั่ง application ยังคงเป็นผู้ execute tool และจัดการ pending work เอง (OpenAI Developers)
ผลคือ Agent ไม่จำเป็นต้อง “ยืนรอ” ทุก tool แบบทีละตัวอีกต่อไป
Mid-turn Steering: AI กำลังทำงานอยู่ก็เปลี่ยนคำสั่งได้
อีกความสามารถที่น่าสนใจมากคือ Mid-turn steering
สมมติเราสั่ง
วิเคราะห์คู่แข่ง 20 บริษัท
แล้วทำรายงานเปรียบเทียบ
ระหว่างที่ Astra กำลังทำงาน เราสามารถเพิ่มคำสั่งว่า
ไม่ต้องวิเคราะห์ 20 บริษัทแล้ว
เหลือ 10 บริษัท
และเพิ่มข้อมูลเรื่องราคาเข้ามาด้วย
เมื่อใช้ Responses API ผ่าน WebSocket ระบบสามารถรักษางานที่ทำเสร็จแล้วและนำคำสั่งใหม่เข้าไปในการทำงานต่อได้ (OpenAI Developers)
นี่ทำให้ interaction เริ่มคล้ายกับการทำงานร่วมกับ “พนักงานที่กำลังทำงานอยู่” มากขึ้น แทนที่จะเป็น request → response แบบเดิม
ปรับระดับ Reasoning ระหว่างบทสนทนาได้
Astra ยังรองรับ configuration_update
หมายความว่าเราไม่จำเป็นต้องกำหนดระดับ reasoning แบบเดียวตลอด conversation
ตัวอย่างเช่น
ค้นข้อมูลทั่วไป
↓
Reasoning: low

วิเคราะห์กลยุทธ์
↓
Reasoning: high

แก้คำสะกด
↓
Reasoning: low
โดยสามารถเปลี่ยน reasoning effort ระหว่าง conversation และยังรักษาประโยชน์จาก prompt cache ได้ (OpenAI Developers)
สำหรับระบบ Agent จริง เรื่องนี้มีประโยชน์มาก เพราะงานทุกขั้นตอนไม่ควรใช้ “สมองเต็มกำลัง” เท่ากันหมด
Astra ไวต่อ Skills และไฟล์คำสั่งมากขึ้น
ตรงนี้น่าสนใจเป็นพิเศษจากสิ่งที่เราคุยกันก่อนหน้านี้เรื่อง SKILL.md
OpenAI ระบุโดยตรงว่า Astra มีความสามารถด้าน Instruction Following สูงขึ้น แต่ผลข้างเคียงคือมันสามารถ ไวต่อคำสั่งที่อยู่ใน Skills และไฟล์อย่าง AGENTS.md มากขึ้น
OpenAI จึงแนะนำให้นักพัฒนา audit ไฟล์ Skills และไฟล์คำสั่งที่โมเดลเข้าถึงได้ เพราะคำสั่งเหล่านั้นสามารถเปลี่ยนพฤติกรรมของโมเดลได้ (OpenAI Developers)
ยิ่งน่าสนใจไปกว่านั้น เอกสารแนะนำให้กำหนด priority ไว้ชัดเจน เช่น
User instructions
↓
Skill guidelines
และถ้า Skill ทำให้โมเดลหยุด ขอ permission หรือเบี่ยงออกจากสิ่งที่ผู้ใช้ต้องการ ก็สามารถสั่งให้โมเดลระบุว่า SKILL.md ตัวไหนและ instruction ข้อไหนเป็นสาเหตุ (OpenAI Developers)
เรื่องนี้เชื่อมกับ Humanizer Skill ที่ปรากฏในบทสนทนาของเราโดยตรง เพราะไฟล์นั้นกำหนดกฎการเขียนจำนวนมาก เช่น ลดภาษาที่ดูเป็น AI, ลดคำฟุ่มเฟือย, ลด em dash, ลดโครงสร้างสำเร็จรูป และทำ final anti-AI pass
พูดง่าย ๆ คือ
Prompt
+
Conversation Context
+
Skills
+
AGENTS.md / Instruction files
+
Tools
+
Model behavior
=
คำตอบและการกระทำของ Agent
ดังนั้นในยุค Astra การออกแบบ Context และ Skills สำคัญขึ้นมาก
OpenAI ยอมรับว่า Astra มี “นิสัยการเขียน” ของตัวเอง
เอกสารระบุว่า Astra มีแนวโน้มเขียนคำตอบค่อนข้างละเอียด ใช้ formatting, Markdown, lists และอาจใช้วลีบางอย่างซ้ำข้าม session
เพราะฉะนั้นถ้าต้องการ output style เฉพาะ ควรกำหนดให้ชัดเจน
OpenAI แนะนำแนวทางอย่าง
ใช้ย่อหน้าที่ชัดเจนและกระชับ
หนึ่งย่อหน้าพัฒนาหนึ่งแนวคิดหลัก

ใช้ list เมื่อข้อมูลเหมาะกับการเปรียบเทียบ
หรือเป็นขั้นตอนจริง ๆ

ใช้ภาษาธรรมดา
ใช้คำที่คุ้นเคย
ใช้ตัวอย่างที่เป็นรูปธรรม
ใช้ active voice
และยังมีคำแนะนำให้หลีกเลี่ยงภาษาสำเร็จรูปของ AI เช่น delve, leverage, it's worth noting รวมถึงรูปประโยคสำเร็จรูปประเภท “This isn't about X. It's about Y.” (OpenAI Developers)
Multi-Agent ยังอยู่ แต่ควรบอก Astra ว่าเมื่อไรให้ Delegate
Astra ถูกฝึกมาให้สามารถแบ่งงานและมอบหมายให้ subagents ทำงานคู่ขนานกันได้
แต่เอกสารเตือนว่าโมเดลอาจ delegate งาน น้อยกว่าที่ workflow ของเราต้องการ
ถ้าเรากำลังสร้างระบบ multi-agent จึงควรกำหนดไว้ชัดเจน เช่น
ถ้างานสามารถแบ่งทำแบบ parallel
และช่วยลดเวลาหรือเพิ่มคุณภาพได้
ให้ delegate งานไปยัง agent อื่น
ดังนั้น Multi-Agent ไม่ได้แปลว่าโมเดลจะกระจายงานเองทุกครั้ง เราสามารถออกแบบ orchestration policy ผ่าน Prompt ได้ (OpenAI Developers)
การทดสอบโค้ดก็ต้องกำหนดระดับให้เหมาะสม
Astra มีแนวโน้มตรวจสอบงาน coding ค่อนข้างละเอียด ซึ่งเป็นข้อดี แต่กับงานเล็ก ๆ อาจกลายเป็น “ตรวจเยอะเกินความจำเป็น”
OpenAI จึงแนะนำให้กำหนด testing policy เช่น
งานแก้ไขเล็กและย้อนกลับได้ ไม่จำเป็นต้องสร้าง test ใหม่ที่เพียงสะท้อน implementation
แต่เมื่อจำเป็นต้อง test ก็ควรใช้ test ที่มีความหมายจริง
และเมื่อการตรวจสอบที่เหมาะสมผ่านแล้ว ไม่ควรวนตรวจซ้ำไปเรื่อย ๆ ถ้าไม่มี failure หรือข้อสงสัยใหม่ (OpenAI Developers)
ความสามารถเดิมจาก GPT-5.6 ยังถูกนำมาด้วย
Astra รองรับความสามารถสำคัญที่มีใน GPT-5.6 เช่น
Computer Use, Structured Outputs, Streaming, Programmatic Tool Calling, Multi-Agent Orchestration, Prompt Caching, Persisted Reasoning, Compaction และ Pro Mode (OpenAI Developers)
ดังนั้นภาพรวมไม่ได้เป็นการทิ้ง architecture เดิม แต่เหมือน OpenAI เพิ่มความสามารถด้าน Agentic Workflow เข้าไปอีกชั้น
สำหรับนักพัฒนา: การย้ายมา GPT-6 Astra
ชื่อโมเดลใน API คือ
gpt-6-astra
OpenAI แนะนำให้ใช้ Responses API โดยเฉพาะเมื่อต้องการ Tool Calling แม้ Astra จะยังรองรับ Chat Completions อยู่ก็ตาม
ถ้าเดิมใช้ reasoning none หรือ minimal ให้เริ่มทดลอง Astra ที่ low แล้วเปรียบเทียบผล
อีกเรื่องที่ต้องระวังคือ Astra ไม่รองรับ parameters บางตัว เช่น
temperature
top_p
top_logprobs
และใน Chat Completions ต้องเอา logprobs ออกด้วย (OpenAI Developers)
สิ่งที่ผมมองว่าสำคัญที่สุดสำหรับคนใช้ ChatGPT โดยไม่เขียน API
แม้เอกสารนี้เขียนสำหรับนักพัฒนา แต่หลักการจำนวนมากใช้กับการเขียน Prompt ใน ChatGPT ได้เหมือนกัน
Prompt รุ่นเก่ามักคิดว่า
Role
+ Task
+ Context
+ Format
แต่กับ Astra ผมจะเพิ่มอีกส่วนหนึ่งคือ Operating Behavior
เช่น
ROLE
คุณเป็นที่ปรึกษาการตลาด

GOAL
สร้างแผนการตลาดที่นำไปใช้ได้จริง

CONTEXT
[ข้อมูลธุรกิจ]

OPERATING BEHAVIOR

ใช้ข้อมูลจากบทสนทนาก่อนหน้า

ถ้าข้อมูลบางอย่างไม่มี
แต่สามารถตั้งสมมติฐานที่สมเหตุสมผลได้
ให้ตั้งสมมติฐานและระบุสมมติฐานนั้น

อย่าหยุดเพียงเสนอขั้นตอน
ให้ลงมือทำงานที่สามารถทำได้

ถ้างานสามารถแบ่งทำคู่ขนานได้
ให้ใช้เครื่องมือหรือ agent ที่เหมาะสม

ตรวจสอบข้อมูลสำคัญก่อนสรุป

ถามฉันเฉพาะเมื่อข้อมูลที่ขาด
สามารถเปลี่ยนผลลัพธ์อย่างมีนัยสำคัญ

OUTPUT
นำเสนอแผนพร้อมสิ่งที่สามารถนำไปใช้ได้ทันที
ความแตกต่างอยู่ตรงที่เราไม่ได้บอก AI แค่ “ทำอะไร” แต่กำหนดด้วยว่า “ระหว่างทำงานให้ตัดสินใจและเดินงานอย่างไร”
นี่น่าจะเป็นทักษะ Prompt Engineering ที่สำคัญขึ้นเรื่อย ๆ เมื่อโมเดลกลายเป็น Agent มากขึ้น
และมีอีกประโยคหนึ่งจากเอกสารที่ผมคิดว่าสะท้อนเรื่องที่เราคุยกันเกี่ยวกับ Skills ได้ดีมาก: Astra มี instruction following ที่ดีขึ้น แต่ในขณะเดียวกันก็ ไวต่อสิ่งที่ถูกใส่ไว้ใน context มากขึ้น (OpenAI Developers)
ดังนั้น Prompt Engineering ยุคต่อไปอาจไม่ได้อยู่ที่การคิด “Prompt เทพ ๆ หนึ่งประโยค” แล้ว แต่คือการออกแบบทั้งระบบ:
Prompt + Context + Memory + Skills + Tools + Agent Behavior + Verification
ให้ทำงานเข้ากัน